国内AIニュース

個人による競馬の定量分析において、学術論文から戦略を抽出する手法を紹介。TypeSafe AIの「Jev」を用いて、大量の論文から有望なものを機械的に仕分けるプロセスの実測値や活用メリットを共有します。

AI Agent基盤モデル選定のための設計メモ。ベンチマーク順位だけで判断せず、総パラメータ数や運用時の役割ごとの成功率・GPU時間を考慮した評価基準の重要性を論じます。

TypeSafe AIの「System Oneモデル」であるJevの解説。文章生成を行わず、分類・真偽判定に特化することで低コストかつ高速な応答を実現する、その用途と推奨される活用法をまとめます。

Claude Codeでeffort設定が反映されない原因と対処法を解説。Windows環境変数に古い設定が残っている場合に起こるトラブルシューティングと、解決手順を共有します。

Embeddingモデル移行時の容量見積もりを解説。API単価だけでなく、ベクトル次元数の変更に伴うストレージ負荷を考慮し、Pythonによる移行コスト計算のシミュレーション手法を紹介します。
OpenAIは2026年9月22日に「GPT-6 Sol」と「GPT-6 Luna」をリリースしました。これらはGPT-6 Astraと同様の学習手法を採用しつつ、前世代モデルと比較して大幅なコスト効率化を実現しています。

AIエージェントによる本番反映時のセキュリティを高める認可ゲートの実装メモ。AIモデルの判断を鵜呑みにせず、短期Leaseを用いた実行直前の検証手順をPythonでの実装例と共に解説。

自社開発のAIアプリビルダーにおけるHTTP API検証結果のレポート。本番環境同等の構成でオーケストレーションをテストし、APIの成功率やシステムリソースの消費量を実数値で報告します。
企業向けスライド生成AIにおいて、生成速度の向上とデザイン品質の改善に向けたアップデートが予定されています。ビジネス資料作成の効率化に期待が寄せられています。

2026年9月22日、OpenAIの「GPT-6 Sol」とAnthropicの「Claude Opus 5.5」が発表されました。両モデルともコーディングやエージェントタスクに特化しており、前世代と比較してAPIコストが大幅に低減されています。特にGPT-6 Solは入力2ドル、出力10ドルという価格設定で提供され、API利用の経済性が向上しています。

研究や実務現場で活用可能な「ローカルAIワークステーション」の構築手法を解説。Ollamaを基盤に、Claude Codeによる自動生成やPlaywrightを活用したE2Eテスト、バグ修正の自動化フローを構築します。単なるチャットツールを超え、RAGやOffice系ソフトへの直接出力など、実務で必要な機能を実装するためのアーキテクチャを紹介します。
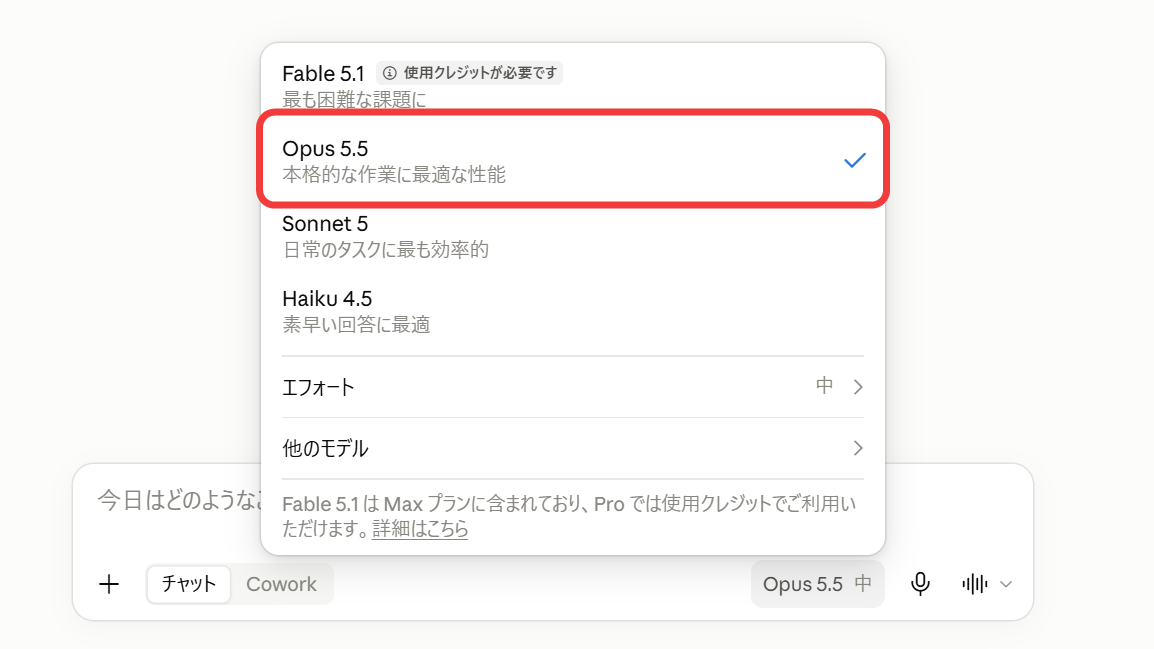
Anthropicが新モデル「Claude Opus 5.5」を発表しました。従来のClaude Opus 5から性能と安全性を向上させつつ、処理コストを40%削減し、出力速度を30%以上高速化させた次世代モデルです。

TypeSafe AIが公開した「Jev」は、文章生成をしないAIモデル。設問に対し確率でマークを返すため、安価かつ高速に構造化データを出力可能です。コストは100万トークンあたり$0.042と非常に低価格です。
LLMのSkill選択を、実行LLMではなく専用のJevに任せることで、LLMの入力を効率化できるか検証。LLM方式とJev方式で同じ依頼文を用いて比較実験を行い、その結果を整理しました。

AIエージェントの会話が後半に進むほどエラーが減るという説を検証。約1万件のログを分析した結果、一見改善しているように見えるグラフは、エラーの多いセッションが早期終了していただけのバイアスだと判明しました。

AIコード納品時のリスクを防ぐ、品質ゲートの3条件。機械的な再現、境界確認、秘密保持の観点から、受託開発現場で確実に納品レベルへ引き上げるための現実的な手法を解説します。

TypeSafe AIが提供する新しいAIモデル「Jev」について解説。テキストを生成しない独自のモデルとして注目されており、Cloudflare Workers AIでの利用方法や仕様の詳細を紹介しています。
AIによるコード生成が普及した現代において、DDD(ドメイン駆動設計)をどう再定義すべきかを考察。コード生成の価値が変化する中で、人間が維持すべき「Truth Asset」の重要性を説いています。

個人開発におけるLLM APIのコスト管理術を紹介。すべてのリクエストに高性能モデルを使わず、タスクに応じてモデルを使い分けることで、品質を維持しながらコストを削減する手法をまとめました。

判定と確率のみを返すAIモデル「Jev」を模したシステムをGoogle Cloud上で3方式構築し、8,453回の試行で検証しました。結論として、低遅延なモデルは精度が低く、高精度なGemini 3.8 Flashはコスト面で大きな課題があることが判明。また、曖昧な表現が含まれるだけで人手なしでの自動処理率が急落する現実も浮き彫りとなりました。