AI TOPIC HUB
Qwen / Alibaba
Alibaba の Qwen シリーズなどオープンモデル最新動向。新着から過去の経緯まで、国内外の情報を時系列で確認できます。
179全記事
2過去7日
156国内
23海外
24入門向け
Qwen / Alibabaの現在地
AI Brief はQwen / Alibabaに関する記事を通算 179 本収集しています。直近30日では 34 本(週あたり約 7.9 本)が追加され、 内訳は国内 156 本・海外 23 本、うち入門向けが 24 本です。 直近90日にこのトピックを最も多く取り上げているのは Zenn LLM(43本)、GIGAZINE(22本)、Zenn AI(19本)、Tom's Hardware(8本)です。 収集済みの最新記事は 2026-09-25 付です。
上の数値は AI Brief が実際に収集した記事の集計で、推定値は含みません。 本数は収集対象メディアの範囲に依存します。
入門から読む
最新ニュース
179件を新着順に表示
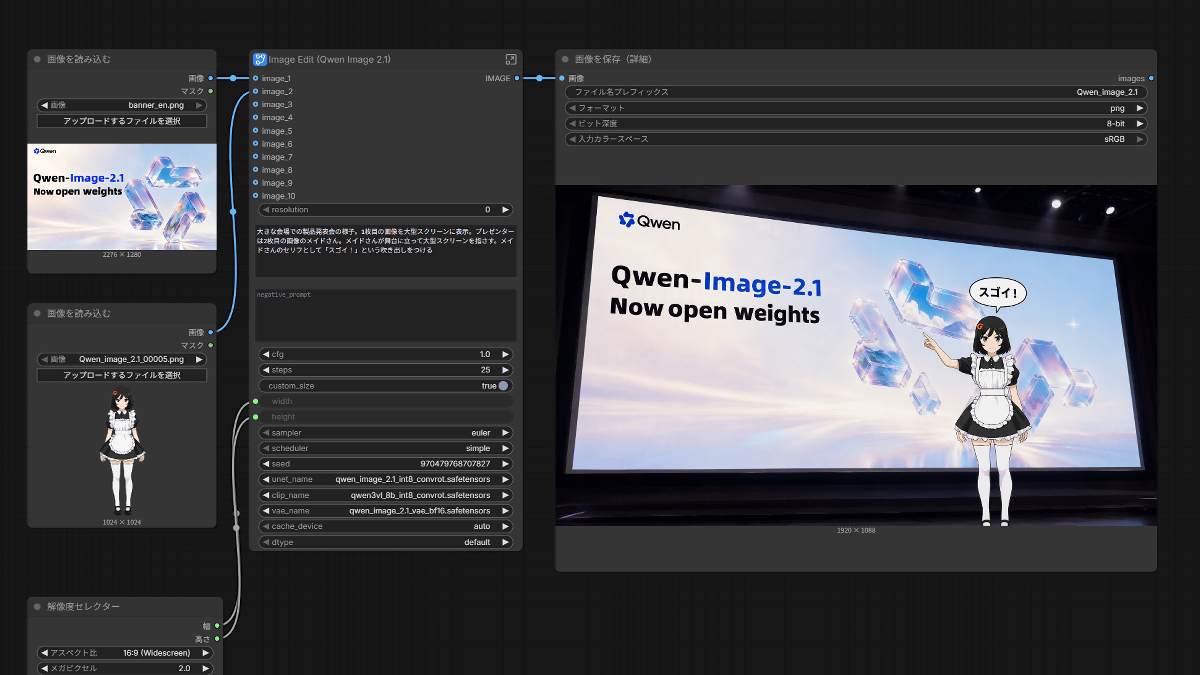
Alibabaが画像生成AI「Qwen-Image-2.1」を公開した。オープンモデルとして無料で利用でき、透過PNG作成や複数参照画像による生成など、ローカル環境での高度な編集に対応している。

ノートPCの内蔵GPUでローカルLLMはどこまで動くのかを検証。Radeon 860MでQwen3-8Bを動かした際の性能指標と動作可能性を報告。
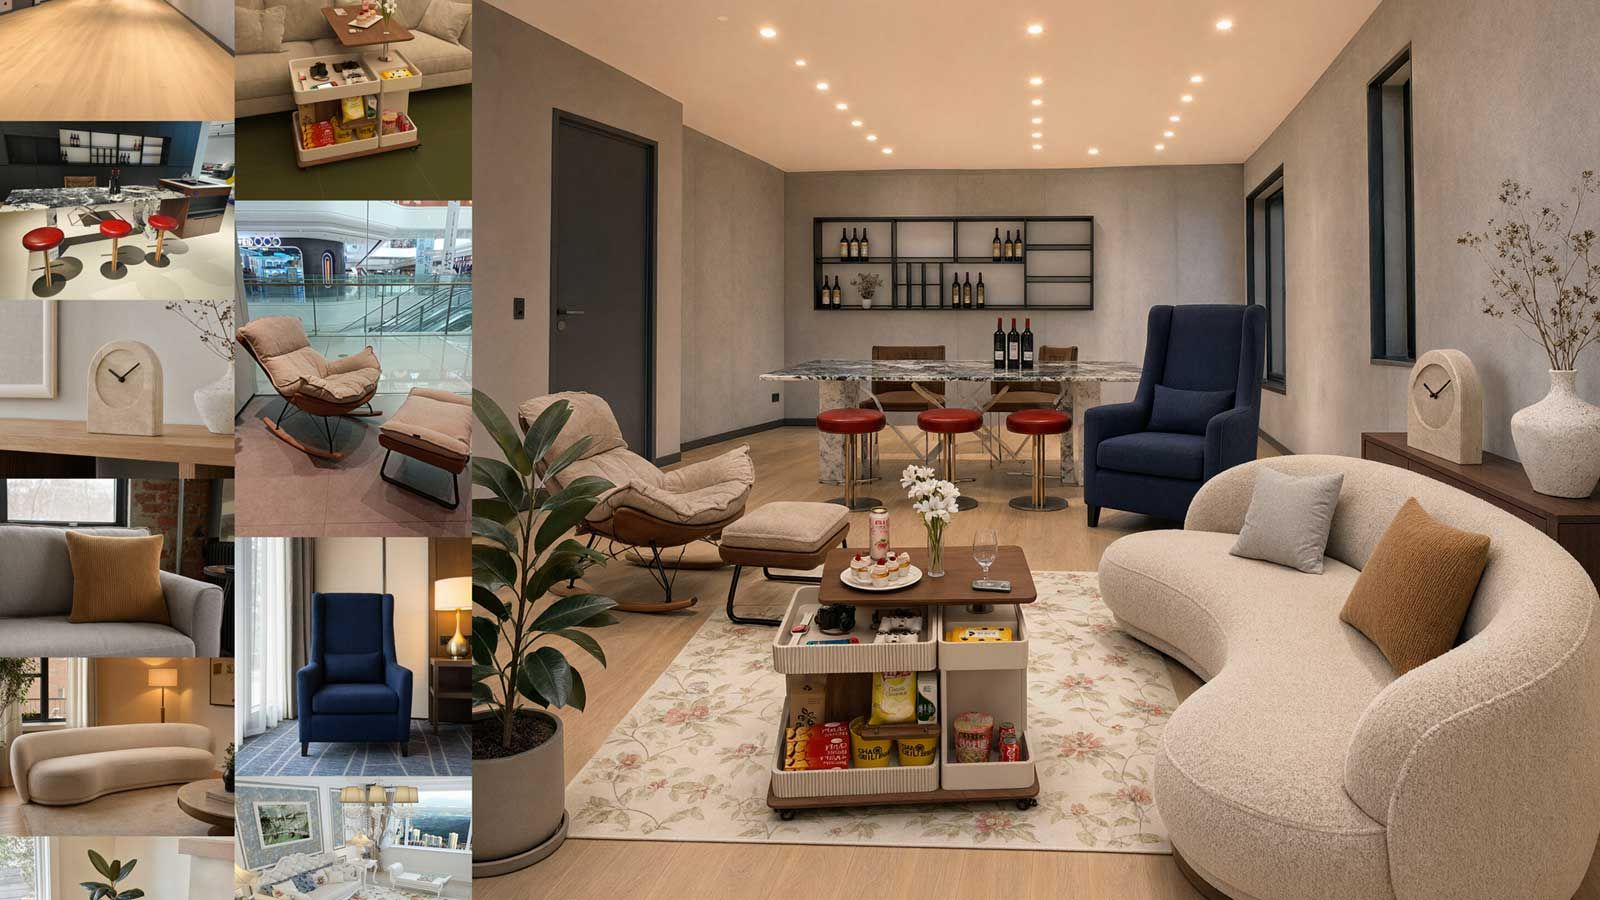
Alibabaは、わずか7Bパラメーターの軽量画像生成AI「Qwen 2.1 Image」を発表しました。RTX 3090などのローカル環境で動作可能でありながら、GoogleのNano 2.0を上回る性能を主張しています。
Alibabaの半導体部門T-Headが、最新AIアクセラレータ「Zhenwu V900」を公開しました。前世代比で3倍の性能を誇り、216GBメモリを搭載。Alibabaが目指す10Tパラメーター規模のAI開発を支えます。

ローカルLLMをPCで楽しむためのガイド。LM Studioなどの無料ツールを使い、検閲なしモデルを含めて自由にAIを動かす環境構築と、近年の軽量化トレンドについて解説する。
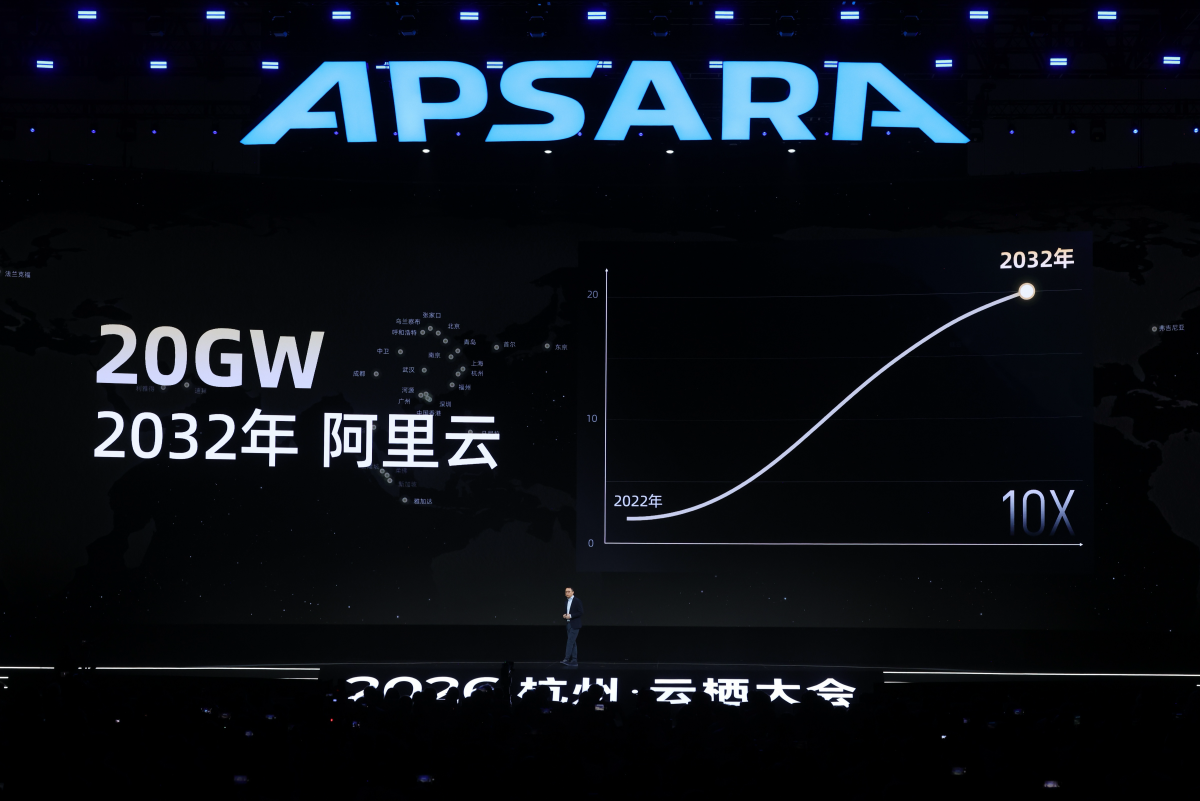
Alibaba Cloudは6年かけて20GWのデータセンター拡張計画を発表しました。米国の勢いと比較すると控えめですが、同社はAIブームが長期間続くと予測しており、それを支える独自チップの準備も進めています。

Alibaba Cloudの最新モデル「Qwen3.8-27B」を、VRAM 16GBのゲーミングPC環境で検証。思考プロセスを調整可能な「Thinkingモード」の強みを活かし、アプリ開発タスクを任せた際の実践的な性能と推論の安定性をレビューします。

STARTO ENTERTAINMENT所属のtimeleszメンバー、猪俣周杜が逮捕されたことを受け、同社が当面の間、謹慎処分として活動休止を発表したというニュース。
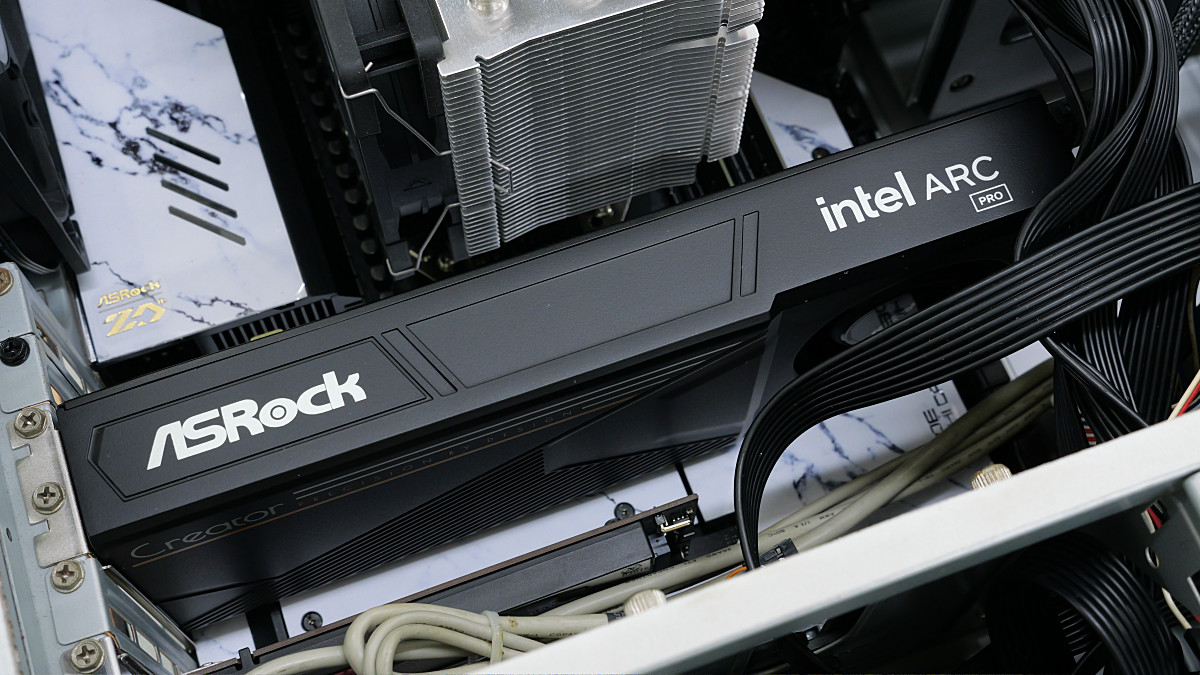
AIモデルの高速実行には大容量VRAMが不可欠ですが、高性能GPUは価格が高騰しています。本記事では、32GBのVRAMを搭載しながら30万円以下で購入可能なIntel Arc Pro B70 Creator 32GBをレビュー。LLMや動画生成AIの実行性能を検証します。

TypeSafe AIのJevに触発され、オープンLLMのlm_headを分類ヘッドに載せ替えて「System Oneモデル」を自作した試み。Qwen3-0.6Bを用いた実装での精度、レイテンシ、パラメーター削減の検証結果を解説する。
アリババのAIモデル「Qwen」シリーズに新モデル「Qwen3.8-Omni-Flash」が登場。動画制作やリアルタイム会話など、ワークフロー全体で高い成果を発揮する。
PrismMLが発表した「Ternary Bonsai 2 27B」は、Alibabaの「Qwen3.8 27B」をベースに、優れたエネルギー効率と高いローカルスループットを実現したモデルです。
会議録音から自動で議事録を作成する仕組みの構築手順。録音終了をトリガーにClaudeで自動生成を行うことで、手動操作の手間を解消し、溜まりがちな録音データの活用を促進します。


RTX 3090 1枚の環境で、Qwen3.8-27B-MTP-q27モデルを使いClaude CodeでWebアプリ開発が可能か検証。適切なパラメータ設定やパフォーマンス評価結果を公開する。
Anthropic社は、中国関連の組織が同社のAI「Claude」を悪用し、台湾攻撃の兵器開発や反魚雷仕様の策定などに関与したと指摘。AIモデルが軍事技術に応用されている実態が浮き彫りになった。
今週のTom's Hardware Premiumでは、Qwen 3.8を多様なハードウェアでテストしました。IFA 2026での動向を踏まえ、現代のコンピューティング状況とAIの最新のブレークスルーについて詳細に分析しています。

Anthropicは最新レポートで、中国のAI企業が同社のAIモデルに対して持続的な「蒸留攻撃」を行っていると指摘しました。AI分野の競争激化に伴い、不正なデータ抽出の手口がより巧妙化しています。

Mac環境でのQwen3.8-27Bの検証第2弾。mlx-dsparkの導入により、Mac Studio M3 Ultra (96GB) において、8bit量子化モデルとDFlash 2を組み合わせる構成が実運用に最適であると結論づけています。

アリババの小型モデル「Qwen3.8-27B」を解説。前世代とアーキテクチャはほぼ同じながら、Thinking区間の挙動が劇的に改善された理由について、実際に動かした知見を元に考察します。

小型LLMとして期待される「Qwen3.8-27B」を分析。前世代とアーキテクチャは同じながら、思考プロセスが劇的に向上した理由について、実装の変化や振る舞いから考察しています。

GPT-2-likeからQwen2-likeへのモデル構造変更実験の第4回。今回はMulti-Head Attention(MHA)をGrouped Query Attention(GQA)へ変更した際の検証結果を報告します。モデルサイズは4.47%軽量化されましたが、学習速度には予想外の変化が見られました。

30BクラスのローカルLLMをコーディング用途で比較。前回評価のMuse Glimmer-30B、Qwen3.8-27B、Gemma4-31B-itを対象に、タスクによる順位の変化とパフォーマンスを検証します。
RTX 5090を使用して最新AIモデル「Qwen 3.8 27B」の推論速度を検証しました。VRAM容量が十分でも、ソフトウェアや推論エンジンの最適化不足が大きな制約となることが判明しました。

DeepSeekが公開した投機的デコーディングフレームワーク「DSpark」の解説記事。LLMの推論高速化技術である投機的デコーディングの基礎から、DSparkがどのような仕組みで性能向上を実現しているかを詳しく掘り下げます。
GPT-2からQwen2への構造変更実験第3回。絶対位置EmbeddingをRoPEに変更した結果、検証Lossと正解率が全seedで改善しました。パラメーター削減と学習時間の変化についても詳述。

2026年8月末に公開されたQwen3.8やGLM-5.3の量子化版GGUFを解説。推論バックエンドの違いにより、出力が最大5割食い違う現象を検証し、ローカル環境での大型MoEモデル運用の注意点をまとめました。

RTX 5060 Ti 16GBを導入したローカルLLM環境構築の記録。旧環境の6GB GPUからのアップグレード背景や、個人が手を出せる現実的なGPU構成、そしてAI活用に向けた機材選定の考え方を整理する。

GPT-2からQwen2へ構造を近づける実験の第2回。活性化関数をGELUからSwiGLUに変更した際の学習時間と精度の変化を検証。LossやTop-1正解率が改善する一方で、学習時間が増加するというトレードオフを報告します。

GPT-2からQwen2への構造移行実験の第1弾。約890万パラメータの小規模モデルを用い、LayerNormをRMSNormへ置き換えた際の影響を比較検証。MPS環境で学習を行い、モデル構造変更が及ぼす結果を報告。

LLMが自律的にNVIDIA CMP 170HXの動作検証を行った報告。ドライバ設定からスタック構築、推論までを実行。マイニング用カードを改造してVRAM 64GB化する特殊環境で、実測検証した作業記録。

M4 Max搭載MacでQwen3.8-27Bを安定稼働させ、OpenAI互換APIとして共有するための最適なアーキテクチャを提案。Tailscaleを活用したプライベートな利用環境の構築指針を示します。

16GB VRAMのローカル環境で、Qwen3系モデルを用いて自律的なコーディングエージェント開発に挑戦。マークダウンビューアーの開発過程で直面したコンテキスト圧迫、無限ループ、速度低下などの課題と克服術を報告。

M4 Max (128GB) で Qwen3.8 Flash Next を動かした実験の追記。Xでの反響をもとに、MLX ServeとMTPを活用した推論速度の検証結果や、llama.cpp利用時の知見を共有する。

Qwen3.8-Flash-NextをDGX Sparkで実行する手順。メモリ容量に合わせてUD-IQ4_XSを選択し、量子化版のGGUFモデルを動作させるための導入ガイド。
Qwen3.8-27Bを中心に、30BクラスのローカルLLM 4モデルを比較検証。生成品質と速度の両面から実用性を評価し、有料APIに匹敵する性能を持つモデルの現場導入可能性について分析します。

Alibaba Qwenチームより、次世代モデルQwen4の先行プレビュー版「Qwen3.8-Flash-Next」が公開。GDN、Gated Residual等の新技術により推論効率と容量を改善。
AIエージェントによる生活記録管理の最適なデータ設計を提案。SQLiteファイルを正本とし、人間は読み取り専用でアクセスする構成を採用した理由を、localStorage地獄からの脱却体験とともに解説します。

AlibabaのAIモデル「Qwen3.8-Flash-Next」の技術解説。125Bのパラメータのうち6Bのみを使用しながら、大規模な397Bフラグシップモデルに匹敵する性能を実現する画期的なアーキテクチャについて記述しています。

2GPU環境でローカルLLM(Qwen3.8 27B)を動作させ、Pi Coding Agentと連携させる実験報告。ハードウェア構成と環境構築の知見を共有する。

RTX 4070 Ti SUPER 16GBを用い、Qwen3.8 27Bモデルをllama.cppで動作させた検証結果。量子化やSpeculative Decodingを駆使し、262Kコンテキストでの推論速度などを計測した実用的なレポート。

製造業の外観検査をローカル環境のVLMで自動化する試みの記録。高精度な画像認識の可能性と、実運用におけるレイテンシの問題について、技術的・現実的な視点から振り返ります。

Qwen3.8:27b-GGUF量子化モデルにおける思考遅延を解消する方法として、llama-cliの「--thinking-effort low」オプションの有効性を検証。精度を保ちつつ無駄なループを抑制する手法を紹介。
llama-cliを用いて、推論の精度や速度を制御するreasoning-effortオプションの使用例を紹介。CUDAを利用した環境での具体的なコマンドライン引数の設定値を提示します。
Eコマースの成長が鈍化する中、Alibaba CloudはAI分野を成長の柱と位置付けています。利益率を向上させるため、欧米製チップへの依存を減らす計画です。

金融業の社内マニュアルをローカルLLMで検索可能にするプロジェクトの記録。セキュリティ制約からクラウドAPIを利用できない環境での構築ノウハウを共有する。

ローカルLLM「Qwen3.8:27b」の性能確認のため、Ollama APIを利用してバッチ呼び出しを行い、ポーリング的な計測を行った実験報告。

AlibabaがリリースしたQwen3.8-27Bの紹介。高性能かつ低VRAM(約8GB〜)で動作可能な点が特徴。量子化により民生用GPUでの運用が現実的となり、ローカルLLMコミュニティで注目を集めている。