国内AIニュース

8Bモデルの1-bitアンサンブルと通常モデルの性能比較。HumanEvalを用いた実測から、用途に応じたモデル選択の基準(精度重視なら単一モデル、スループットならアンサンブル)を提示。

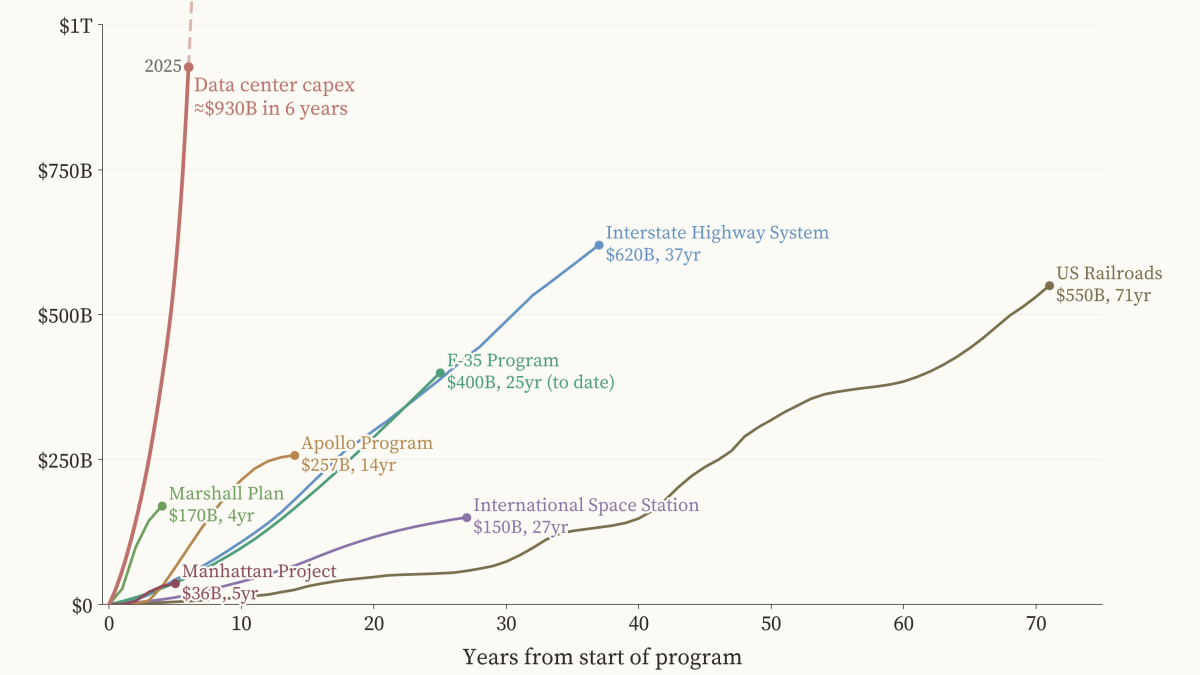
生成AIの普及により転換期を迎えた日本のSIer業界を分析。人月モデルの限界を指摘し、DX推進に必要な「ROIを明確に示す提案力」の重要性を、経産省やIPAの調査データを基に考察する。

Macユーザー向けローカルLLM導入ガイド。Ollamaを利用し、スペックに応じたレベル別の学習が可能。コーディング支援から自作チャットアプリ開発までの実践的な構成を紹介。


AIの自律運用において「作業完了」と早とちりする課題に対し、数値目標・SEO軸・定時観測・記憶ログによる構造的な解決策を実装。Xのフォロワー獲得数も改善した事例を解説。

コードレビューにおける「PRのコメントは恥」という格言を題材に、AI時代における人間の役割を考察。ツールに頼る前にまず自身で疑う姿勢の重要性を説く。

AI×SaaS連携の乱立によるシャドーIT化を防ぐため、Model Context Protocol(MCP)を用いた全社的AI基盤の構築を提案。情シス・DX部門向けに、統制とAI活用を最大化するサーバー選定と運用のヒントを解説。
VLMs(視覚言語モデル)の推論を最適化する「WindowQuant」論文の要約。ウィンドウ単位の類似性に基づいたKVキャッシュの混合精度量子化手法について、技術的な要点と背景をまとめた読書メモ。

ローカルLLMに「トーン規約」をプロンプトでどこまで教えられるかを検証した記録。5通りのプロンプトとモデル世代による出力を比較し、概念的なトーン指定に対するモデルごとの限界や精度の違いを分析する。

ISUNARABE合同演習2026への参加記録。Grafana、Prometheus、Pyroscope、Lokiなどをdockerで一括構築し、サーバー計装を行うための自動計測環境の整備について解説しています。

AGENTS.mdの設定だけではAIエージェントの品質が安定しない理由を解説。Martin Fowlerの論文を引用し、明示的な制約だけでなく、AIにどう振る舞わせるかの根本的な設計の重要性に触れています。

AIガバナンスにおける「Human-in-the-loop」の限界と、責任経路工学における「Human Return Point」の概念を解説。人間がループに参加するだけでは不十分な理由と対策を論じます。

Claude Codeを複数同時に動かす際の作業衝突問題に対する解決策。git worktreeを用いて物理的にディレクトリを分離し、環境を分けることで安全に並行開発する方法を提案します。

開発プロジェクトの「振り返り」をAIエージェントとの対話で半自動化するプロジェクト「Clio」の紹介記事。執筆のコストを削減し、開発記録を効率的に言語化する方法を提案します。

LLMの出力の揺らぎ(非決定性)を前提とし、プロンプトチューニングの効果を定量的に評価する方法を紹介。正解が定義可能なシステムでの機械学習的な評価手法の応用について解説します。

ローカルLLMを使用してCodex CLIを駆動させる方法を解説。Ubuntu環境を中心に、OpenAI互換APIを利用してエージェント性能を評価するための構築手順と背景を紹介する。

複数のAIコーディングエージェントを並行運用する際のターミナル管理の課題を指摘。各エージェントの状態や役割が見えなくなる問題に対し、現状の運用と課題を考察しています。