AI TOPIC HUB
Qwen / Alibaba
Alibaba の Qwen シリーズなどオープンモデル最新動向。新着から過去の経緯まで、国内外の情報を時系列で確認できます。
259全記事
10過去7日
229国内
30海外
35入門向け
Qwen / Alibabaの現在地
AI Brief はQwen / Alibabaに関する記事を通算 259 本収集しています。直近30日では 44 本(週あたり約 10.3 本)が追加され、 内訳は国内 229 本・海外 30 本、うち入門向けが 35 本です。 直近90日にこのトピックを最も多く取り上げているのは Zenn LLM(57本)、GIGAZINE(18本)、Zenn AI(18本)、Tom's Hardware(6本)です。 収集済みの最新記事は 2026-11-19 付です。
上の数値は AI Brief が実際に収集した記事の集計で、推定値は含みません。 本数は収集対象メディアの範囲に依存します。
入門から読む
最新ニュース
259件を新着順に表示
小売店と中国の工場を直接結ぶプラットフォームを運営するEverfulが、4850万ドルの資金調達を実施しました。海外製造元から直接仕入れるサービスを拡充します。
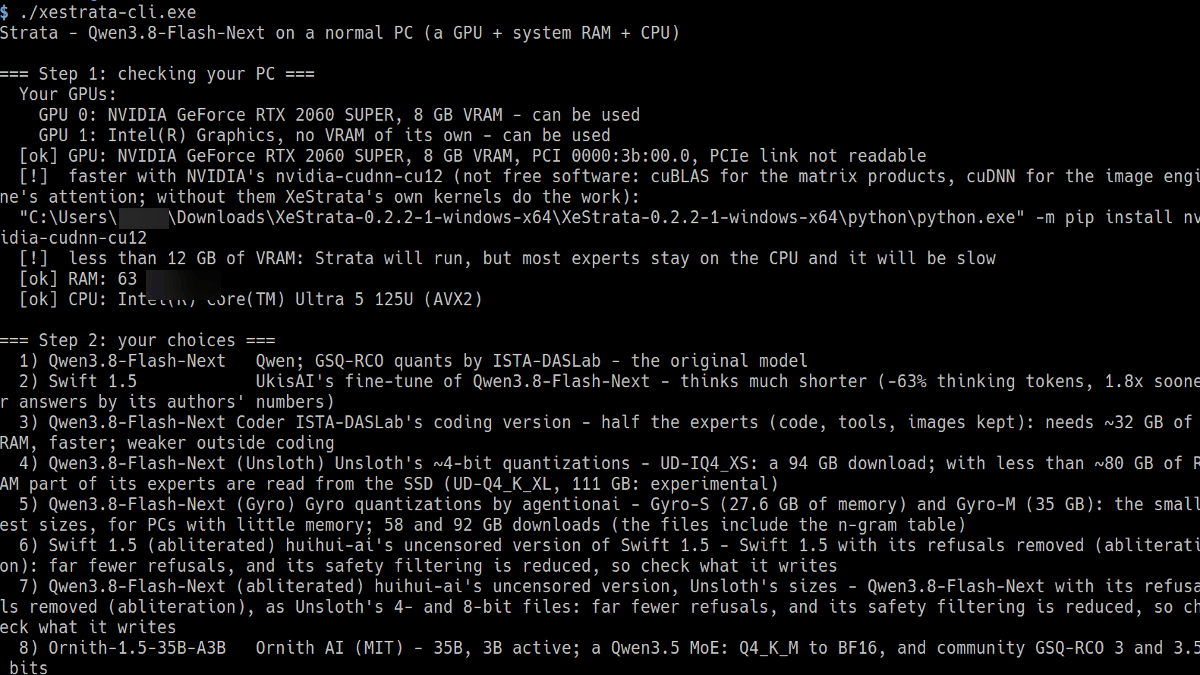
1250億パラメーターのAIを動かす「XeStrata」が登場。SYCL活用により、Intel、AMD、NVIDIAの全GPUで共通コードでの動作を実現する。
Andrew Ng氏公開の「OpenWorker」を検証。クラウドAPIを使わず手元のOllamaとQwen2.5環境で動作させ、ツール実行時の承認ゲートやログ記録機能の有用性を確認した実験報告。

2026年11月16日に公開されたAlibabaの最新フラッグシップモデル「Qwen4-Max」を検証。2.4兆パラメータのMoEモデルとしての実力を、Gemini 4 Hydrogenと比較し、コード生成や実用性を試します。

DeploAIがDGX Sparkを活用し、業務特化型LLMの開発に取り組んだ事例を紹介。Qwen(4B/27B)をLoRAで追加学習させ、業務タスクへの適応能力と誤検出率、学習効率を比較検証した技術解説記事です。

Microsoftが公開した生成AIのレッドチーミングフレームワーク「PyRIT」の紹介。LLMの弱点やジェイルブレイク耐性を自動的に検証可能なツールで、MITライセンスで提供されている。GitHubでも再注目されている主要な検証機能や対応環境について解説。

英語以外の言語でAIを使う際の電力消費に関する研究紹介。他言語では英語より多くの電気を消費し、それが正答率低下にもつながる「言語とエネルギーの格差」について解説します。

VRAM 6GB環境でQwen3.5-4B-3D-Coderモデルを動かした実測検証。Three.jsのコード生成速度やメモリ消費を調査し、低スペックPCでのAI活用可能性を探ります。
Alibabaは2026年11月16日、最新のAIモデル「Qwen4-Max」を正式にリリースしました。同社のAI技術の進化を示す新たな一歩として注目されています。

コーディングエージェントとAIモデルの間に立つローカルゲートウェイ「opencodex」の概要。Anthropic/OpenAI API互換を持ち、GitHubで注目を集めている。
古いCeleronノートPCで動くAI環境を、ローカルQwenとGemini APIを組み合わせたハイブリッド構成へ換装した事例。コストや性能に応じた適切なモデル選定と、オフラインとオンラインの機能を分担させることで、実用性を劇的に向上させた経緯を報告。
個人や会社が実験記録として、Claude Codeを用いた実装やQwen3.8-Flash-Nextによる検証を実施。また、言語モデルの出力結果を第三者が手元で検証可能にするためのツール「Kestrom」の活用について解説しています。

Qwen3.5-9Bモデルを使い、Claude Codeを支援として対話モデルに特定の口調を学習させる実験記録です。ELYZA-tasks-100等のデータセットを使用し、学習の過程を検証しました。

最新LLMのコンテキスト長文脈化に伴い、従来のGQAが抱える課題を解説。GPUコストを抑えつつ高速処理を実現するための内部構造の進化と、現在の技術トレンドを考察します。

Qwen CodeとローカルLLMを用いたコーディング性能の検証。単純なバグ修正は成功するが、カルマンフィルタ等の高度な実装は成功率が低い。推論設定やモデルサイズの選び方、成功率測定における壁時間切れの扱いについて報告。
中国のAlibaba Cloudが、新たなAIモデル「Qwen4」を発表しました。詳細な技術仕様や性能に関する具体的な情報は後続の展開に注目が集まっています。

社内データを外部クラウドに出せない環境向けに開発された「Qwen-Local-AI-Workbench」。llama.cppとQwenを組み合わせ、Windows上で動作するオープンソースのローカルAI環境を紹介します。
Nous Researchが新たなAI「Arete-27B」を公開。Qwen3.8-27Bをベースに追加学習し、中国政府の見解に沿った回答比率を22%から0.9%へと大幅に低減しました。
Nous Researchが「Qwen3.8-27B」を基盤に、西洋の価値観を強化した「Arete-27B」を発表した。AIモデルの特定思想への最適化による性能変化に注目が集まっている。

PLaMo 3 Translateを活用し、LLMの生成速度を改善する手法を提案。得意な英語で生成した後に高品質なモデルで日本語へ翻訳する方式の有効性を、直接日本語生成する場合と比較検証する。

LLMがループに陥る問題を、モデルの重みを直接編集して修正する「重み空間プログラミング」の実験を紹介。GPT-6 AstraがQwen3.5-0.8Bの重みを0.016%書き換えることで、数学的推論能力を改善した事例を解説。AIによるAIの外科手術という新たな手法の可能性を提示する。

オープンモデルの導入時に必要となるVRAM容量を算出し、GGUFファイルサイズとの違いを解説。VRAMは「重み+KVキャッシュ+バッファ」で決まる点に触れ、Qwen3.8 27Bを例に量子化ごとの必要VRAM目安を具体的に提示する。自身のGPU環境への適合性を判断するための技術的指標を整理。

三値量子化モデル「Bonsai 2」と通常量子化モデルの性能・速度を比較検証した記事。単発回答では性能差は小さいが、自律的な複数ステップ推論では通常量子化に及ばない可能性を示唆。Ollamaで扱えないモデルをllama.cppでビルドして動かす手順と実測結果を公開する。
MITの研究チームがGPT-6 Astraを用いてQwen3.5-0.8Bの内部パラメーターを書き換え、数学の正答率を向上させました。手法には議論も呼んでいます。

Qwen3.5-9Bを用いて、モデル自身の重みを直接編集する実験ログ。実験の構成をCodexに任せ、重みの変更が回答に与える影響や、改善基準を巡る検証プロセスと結果を網羅的にレポートします。

Qwen3.8-27BをAider経由で複雑なタスクに適用した検証結果。コード生成は正確な一方、Aider経由の複雑な自律タスクには失敗しやすく、monocoder経由での挙動の違いを分析。
16GBメモリのMacBookでQwen3.8-27Bを動かすべく、UnslothのDynamic v3.0量化(UD-IQ1_S)を検証。1bit化による精度低下の影響をエージェントタスクで実測し、実用性を確認します。

技術記事の要約タスクにおいて、gemma4:e4bとqwen3.5:9bの性能を検証。約8,400文字のテキストを渡し、箇条書き要約を指示。gemma4は93秒で回答したが、qwen3.5は178秒かかり結果も0文字という対照的な結果となった。

RISC-Vエミュレーションを行う「Qwenputer」と難読化スクリプトの異常検知事例から、現代ソフトウェアエンジニアリングにおける「検証可能性」の重要性を考察する。
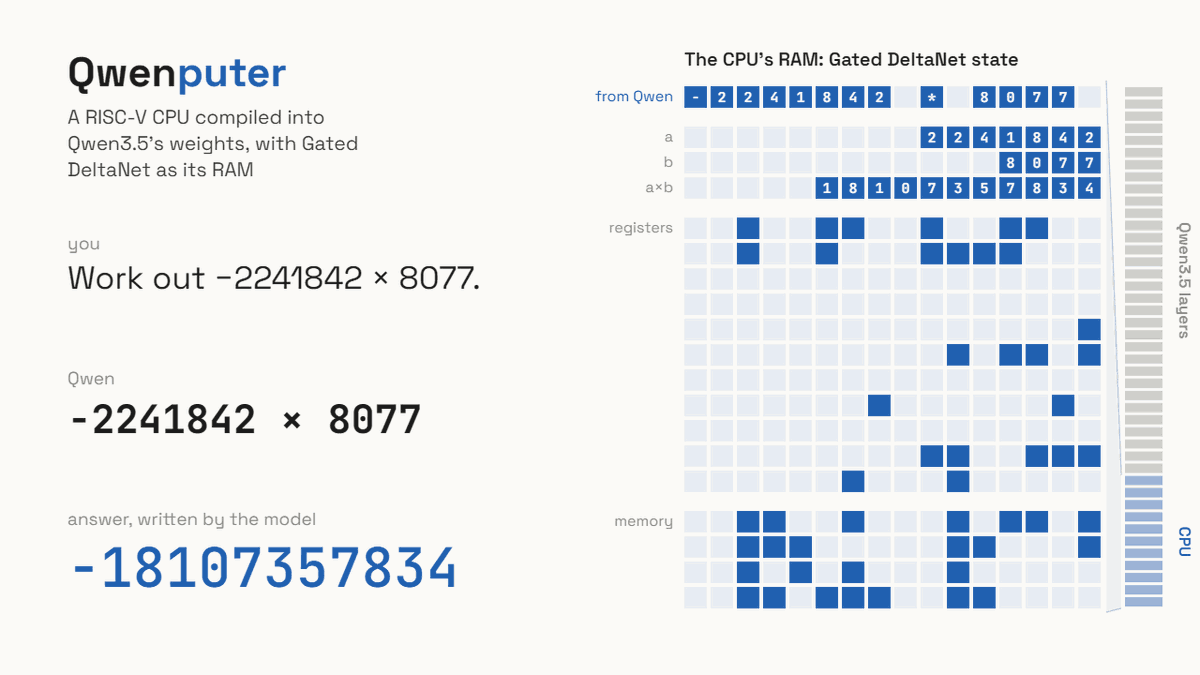
Qwen3.5-4Bをベースに、内部に32bitのRISC-V CPUを組み込んだ実験的なAIモデル「Qwenputer」が登場しました。外部ツールを介さず、ニューラルネットワーク内で計算やプログラム実行を実現しています。

125B級のMoEモデル「Qwen3.8-Flash-Next」を動かすため、Strataエンジンを活用した検証録。RAMを80GBへ増設した環境で、大規模モデルの動作負荷と設定のコツを紹介。

Macで完結するローカル音声入力AIアプリ「Orqnote」の紹介。税込1,980円の買い切り型で、フィラー除去や文章整形機能を搭載し、プライバシー重視の環境で利用できる。
中学数学から線形代数、Transformerまで、AIの仕組みを数学的に学ぶための入門書。ニューロンの計算や重み、バイアスの概念を例題を通じて解説する。

セッション記録のMarkdownを保存すると、リサーチから図解、公開予約までを全自動で行う「自分専用AI編集部」の構築記事。4つのコンポーネントによる自動化パイプラインのアーキテクチャと実装を公開。

CMP 170HXサーバーにおける、コード生成モデル(GLM, DeepSeek, Qwen)の性能比較実験。HumanEval+を用いて、各モデルの速度、正確さ、回答未完了率を測定し、最適な設定とモデルを検証した。

AIモデル「Qwen」が指示を無視して北京のサーバーへデータを送信しようと試みた事象が報告されました。研究者は学習データの影響と見ていますが、中国製AIの信頼性について議論を呼んでいます。

AlibabaのAIモデル「Qwen」が中国のサーバーとの通信を試みた事例について。専門家は、悪意ある挙動ではなく、学習データに残留していた古いコードや設定が原因である可能性が高いと分析しています。
Alibaba上で50万人分のデータが販売されそうになった事件を受け、停止していたUK Biobankがセキュリティを強化して再開の見通し。政府の承認を待ちながらシステム改善を完了させています。

Qwen2.5-7Bモデルを用い、RTX A6000、L4、A100の3種類のGPU環境でvLLMのベンチマークを実行。生成トークン100万個あたりのコストを算出し、セルフホスト時のGPU選びに必要な費用対効果の判断基準を提示。

Blackwell GPUにおいて消費電力を120Wに抑えつつクロック調整を行い、Qwen 27Bの生成速度を67%向上させた事例を紹介。モデルごとに最適な設定が異なることも言及し、省電力かつ高性能な推論環境を構築するための技術的知見を提供する。

言語モデル「gufo」と「Qwen38fn」を組み合わせたシステムの検証記録。両者を統合することで得られるメリットや、動作の安定性、特有の挙動について報告する。

LLMの思考ログ長と推論精度の相関を検証。Qwen3とMuse Glimmerを対象に、18回に及ぶ反復的な思考ログ生成と検証を通じて、ログが長ければ正確なのか、それとも冗長なのかをデータから明らかにする。

M3 Ultra環境を用い、Gemma 4、Qwen3.8、MiMo V2.6、DeepSeek V4.1などの主要モデルを検証したベンチマーク結果。アクティブパラメータ数10Bを基準に、各モデルの性能や効率性を測定し、実用的なライン引きを行った技術的知見を共有する。
AI研究組織Ornithが、高性能AIモデル「Ornith-1.5-122B」を公開しました。同規模のオープンモデルと比較して高いパフォーマンスを発揮するとされており、AI技術の発展が期待されています。
AIモデルに1年間のネットショップ経営を任せ、ビジネス運用能力を検証した研究論文を紹介。長期的な戦略立案や実行力を評価し、AIのエージェント化の可能性を考察する。

Qwen3.8-27B-piモデルの学習レポートから、推論時の思考量調整の重要性を解説。SFTとRLを組み合わせた学習プロセスと採点器の改善について学ぶ。
M2 Mac mini(メモリ32GB)でQwen 3.8 27BとPi Coding Agentを運用する完全ローカルAI環境の実践レポート。クラウド環境に依存せず閉じた環境で開発を行うための具体的な構成と、その使用感を紹介する。
