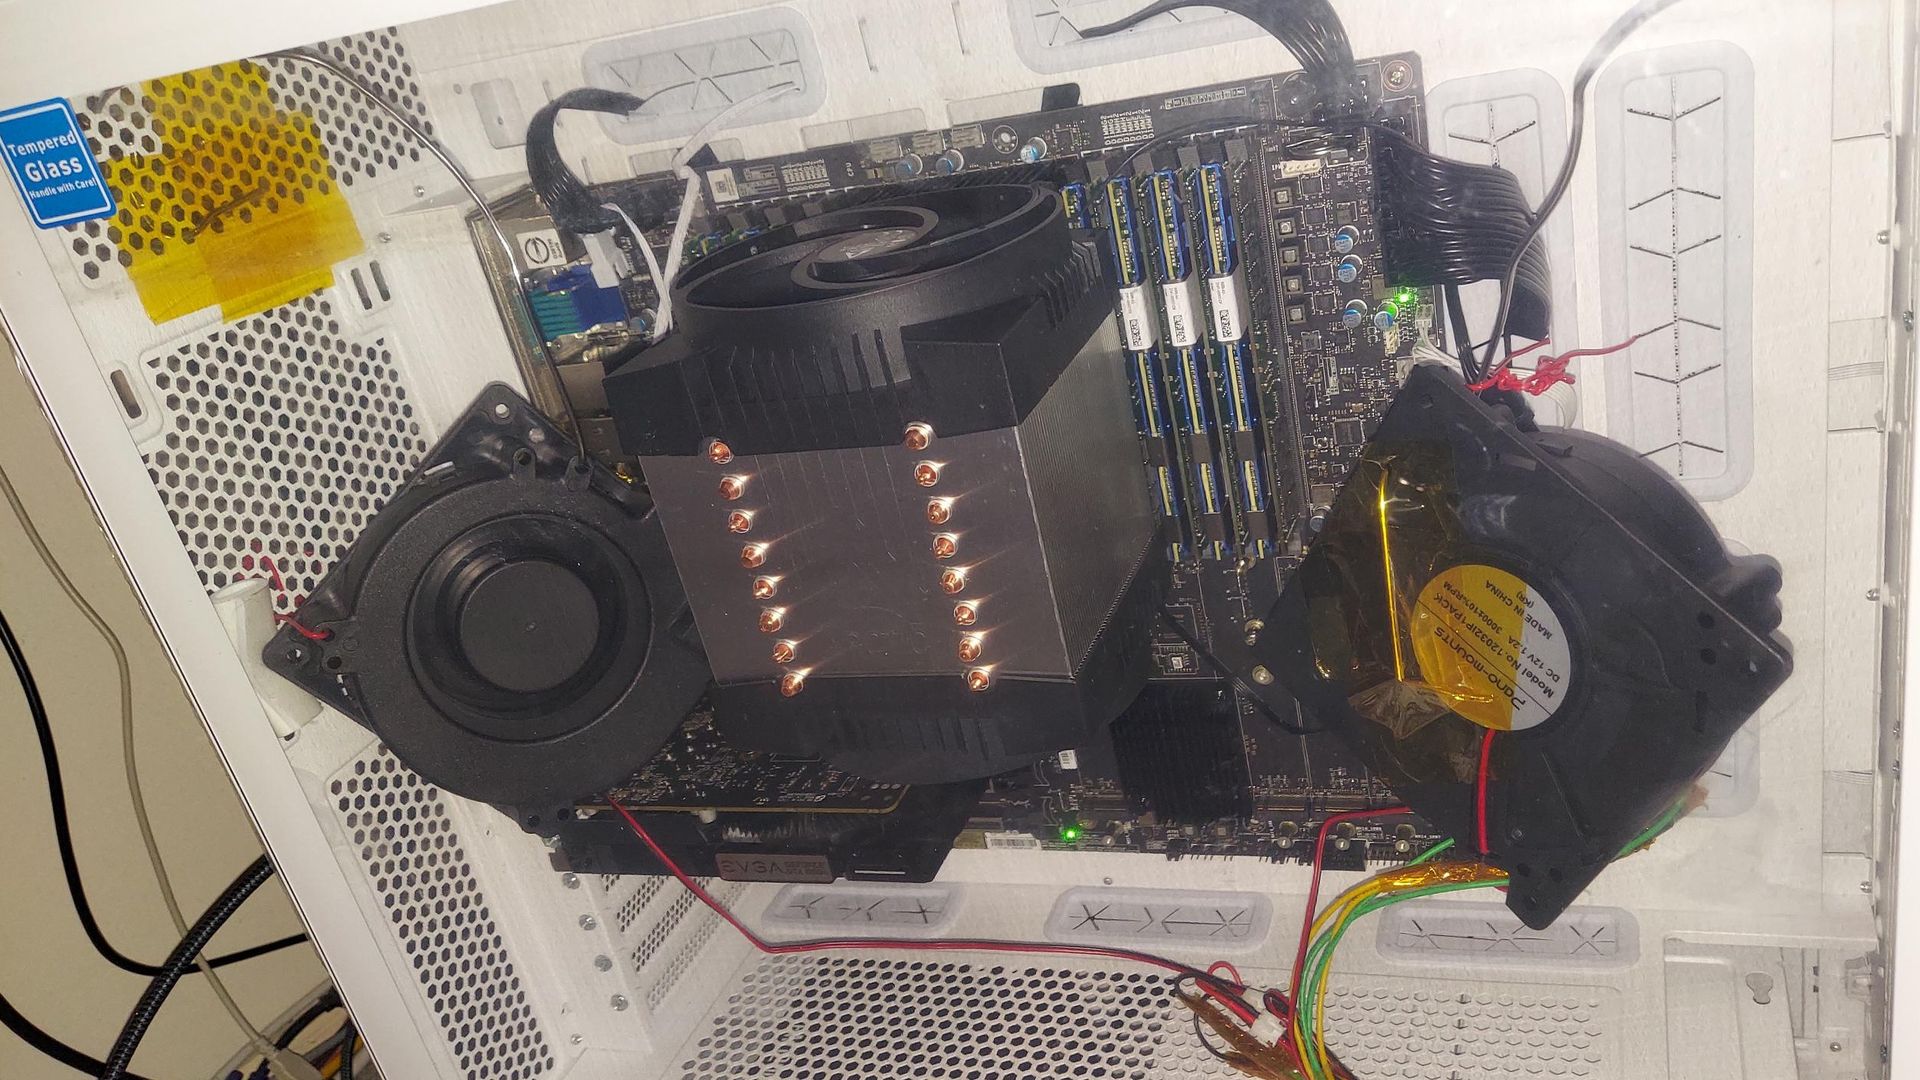
あるRedditユーザーが、Optaneメモリと2基のRTX 3090を組み合わせた自作サーバーで、2.8兆パラメータという巨大なAIモデル「Kimi K3」を毎秒3.11トークンの速度で動作させることに成功しました。商用ハードウェアなしで大規模言語モデルを個人環境で実行する、画期的な技術的成果です。
個人サーバーで2.8兆パラメータのAIを稼働、RTX 3090とOptaneメモリで実現
Homelabber’s second-gen Optane build uses two RTX 3090s to run 2.8-trillion-parameter Kimi AI model at 3.11 tokens per second
- 何が変わったか
- あるRedditユーザーが、Optaneメモリと2基のRTX 3090を組み合わせた自作サーバーで、2.8兆パラメータという巨大なAIモデル「Kimi K3」を毎秒3.11トークンの速度で動作させることに成功しました。
- 誰に関係するか
- 開発者・技術責任者 ※タイトル・要約からの推定
- 次に確認すること
- API仕様、互換性、利用制限を公式情報で確認 ※タイトル・要約からの推定
このニュースの背景・続報
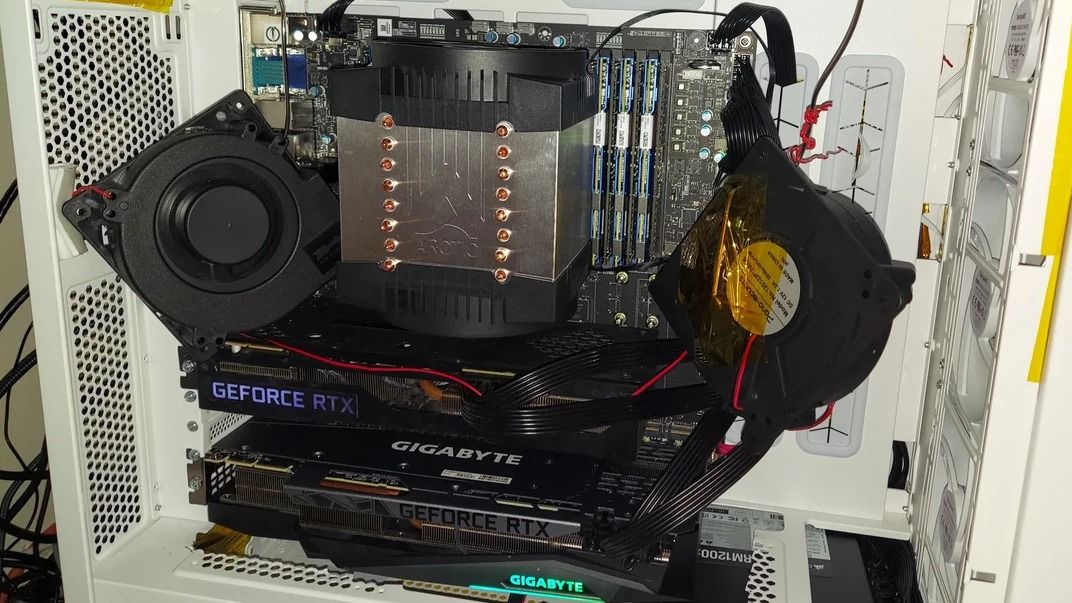
編集メモ: 商用サーバーを介さずとも、高性能なGPUとメモリ構成の工夫により、2.8兆パラメータもの巨大モデルを個人レベルで運用できることは、AI開発の民主化と技術的進化を象徴する事例です。
自動判定による詳細な影響を見る
EDITORIAL SIGNAL
重要度 参考このニュースの影響
現時点では動向把握を目的とする参考情報です。
影響を受ける人
- 開発者・技術責任者
確認すること
- API仕様、互換性、利用制限を公式情報で確認
今後の注目点
公式発表、提供条件、利用者への実際の影響
タイトル・要約の語句に基づく自動判定です。最終判断は公式発表・一次資料をご確認ください。